什么是范数?用 NumPy 动手算一遍就明白了
做数据科学和机器学习,范数(Norm)这个东西你迟早会碰到。 损失函数正则化、向量相似度计算、矩阵分解——这些场景背后都…
- Python
- 2026-10-08
做数据工程的人大概都有过这样的经历:每天到工位第一件事,打开终端敲几条 SQL,看看关键表的行数是不是正常、最新数据更新到几点了、字段空值有没有突然飙高。 这套检查做完,可能半个小...
- Python
- 2026-10-07
数据工程师每天打交道的东西,很大一部分是文本: 应用日志 Nginx access log CSV 里混着脏数据的字段 API 返回的 JSON 片段 配置文件 爬下来的 HTML...
- Python
- 2026-10-05
前阵子对账,一笔订单 3 件、单价 19.99,脚本算出来的应收是 59.96999999999999531041794398。写这段代码的人其实已经"用了 Decimal",问题...
- Python
- 2026-10-04


日常数据处理中,经常遇到需要把一批 CSV 文件汇总到一个 Excel 工作簿的场景——每个 CSV 对应一个工作表,方便统一查看和分发。Python 原生 csv 模块可以读取数...
- Python
- 2026-09-30
Python 的 datetime 有个很阴的设计:同一个类型既可以带时区(aware),也可以不带(naive),两种对象长得一样、方法一样,大多数时候混着用也不报错。等它出问题...
- Python
- 2026-09-30
Pycharm社区版下载地址(2026最新,送安装、汉化、使用教程)
Pycharm 是一款 Python 专业的集成开发工具, 由知名公司 JetBrains 专门为 Python 开发量…
- Python
- 2026-09-29

用Pandas+Pydantic搭建数据清洗与验证管道
数据清洗是每个和数据打交道的人都绕不开的日常。 无论是做分析、跑模型,还是给业务方出报表,拿到的原始数据往往都带着重复记…
- Python
- 2026-09-29
XGBoost 和 LightGBM 你已经调得很熟了,但只要数据里有一堆字符串类型的类别列,就免不了一段重复劳动:pd.get_dummies() 一下炸出几百列,或者 Labe...
- Python
- 2026-09-29
手把手带你走一遍:机器学习模型如何用FastAPI和Docker部署
你大概用过不少健康管理类的App——输入年龄、性别、BMI、血压,再填几项血液指标,它就能给出一个风险评分或健康提示。 …
- Python
- 2026-09-28
前两天帮朋友看一个后台系统,他问了个问题:用户点了「退出登录」,前端把 token 删了,但如果这个 token 之前已经被人抓包拿走,拿着它还能调接口吗? 答案是能,一直能用到它...
- Python
- 2026-09-28
训练一个 XGBoost 模型要等十分钟,换 LightGBM 同样的数据只要一分钟,精度还差不多。这不是玄学,是两者在构造决策树的方式上有根本差异。 这篇文章解决四件事:Ligh...
- Python
- 2026-09-28
处理数据的时候,最让人头大的往往不是复杂的模型调参,而是那些藏在角落里的异常值。 你是不是也遇到过这种糟心事:明明业务逻辑看着没毛病,一跑统计指标就飘红;或者模型效果突然断崖式下跌...
- Python
- 2026-09-26
处理 PDF 表格数据的场景很常见:季度报表、对账单、业务台账,业务方给一份 PDF 过来,需要结构化后进数据库做后续分析。本文分享一个完整的 Python 实现,覆盖从表格提取、...
- Python
- 2026-09-22
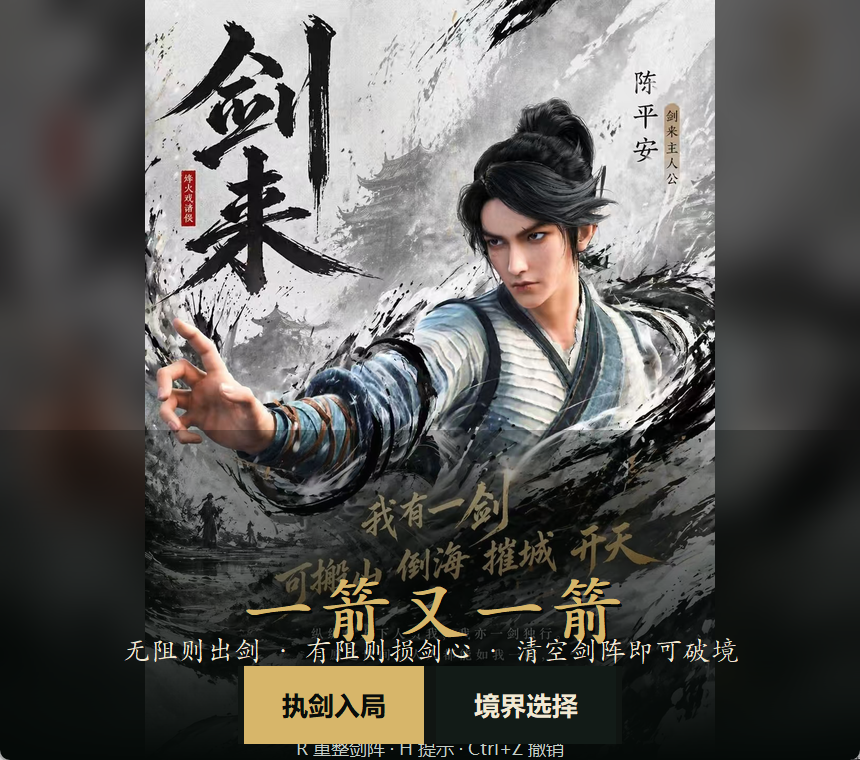
2026秋软件工程个人作业(第二次)——一箭又一箭(完善版)
作业信息 项目 内容 这个作业属于哪个课程 2026 秋软件工程与软件工程实践 这个作业要求在哪里 2026 秋软件工程…
- Python
- 2026-09-21
2026秋软件工程个人作业(第二次)——一箭又一箭
作业信息 项目 内容 这个作业属于哪个课程 2026 秋软件工程与软件工程实践 这个作业要求在哪里 2026 秋软件工程…
- Python
- 2026-09-18
写过一些 Python 服务和脚本后我发现,很多人(包括早期的我)一遇到"要并发"就凭感觉开线程:请求慢了开线程、算得慢了也开线程,跑起来才发现,IO 任务确实快了,可 CPU 密...
- Python
- 2026-09-18